
Clases
Acá estarán disponibles los recursos para las clases. El tl;dr es una breve explicación de la misma. Para cada clase, intentaremos compartir el link del video de YouTube y el material asociado.
-
 00 - Introducción al curso - (Parte 1)
tl;dr: Repaso de ML y conexión con DL. Inicio de repaso de NN (último tema de ML)
[Link clase] [Jupyter Notebook]
Contenido
- Repaso ML objetivo principal
- Comparar ML clásico con DL
- Inicio de repaso estructura de Redes Neuronales
-
 00 - Introducción al curso - (Parte 2)
tl;dr: Repaso clase 2 desde representación con ReLU hasta PyTorch
[Link clase] [Jupyter Notebook]
Contenido
- Reconstrucción de funciones linelaes definidas a trozos con ReLU
- TAU
- Representación gráfica con 2 dimensiones de entrada
- Número de regiones lineales de interés
- PyTorch
-
 00 - Introducción al curso - (Parte 3)
tl;dr: F(x1, x2); Número de regiones lineales;PyTorch
[Link clase] [Jupyter Notebook]
Contenido
- Representación gráfica con 2 dimensiones de entrada
- Número de regiones lineales de interés
- PyTorch
-
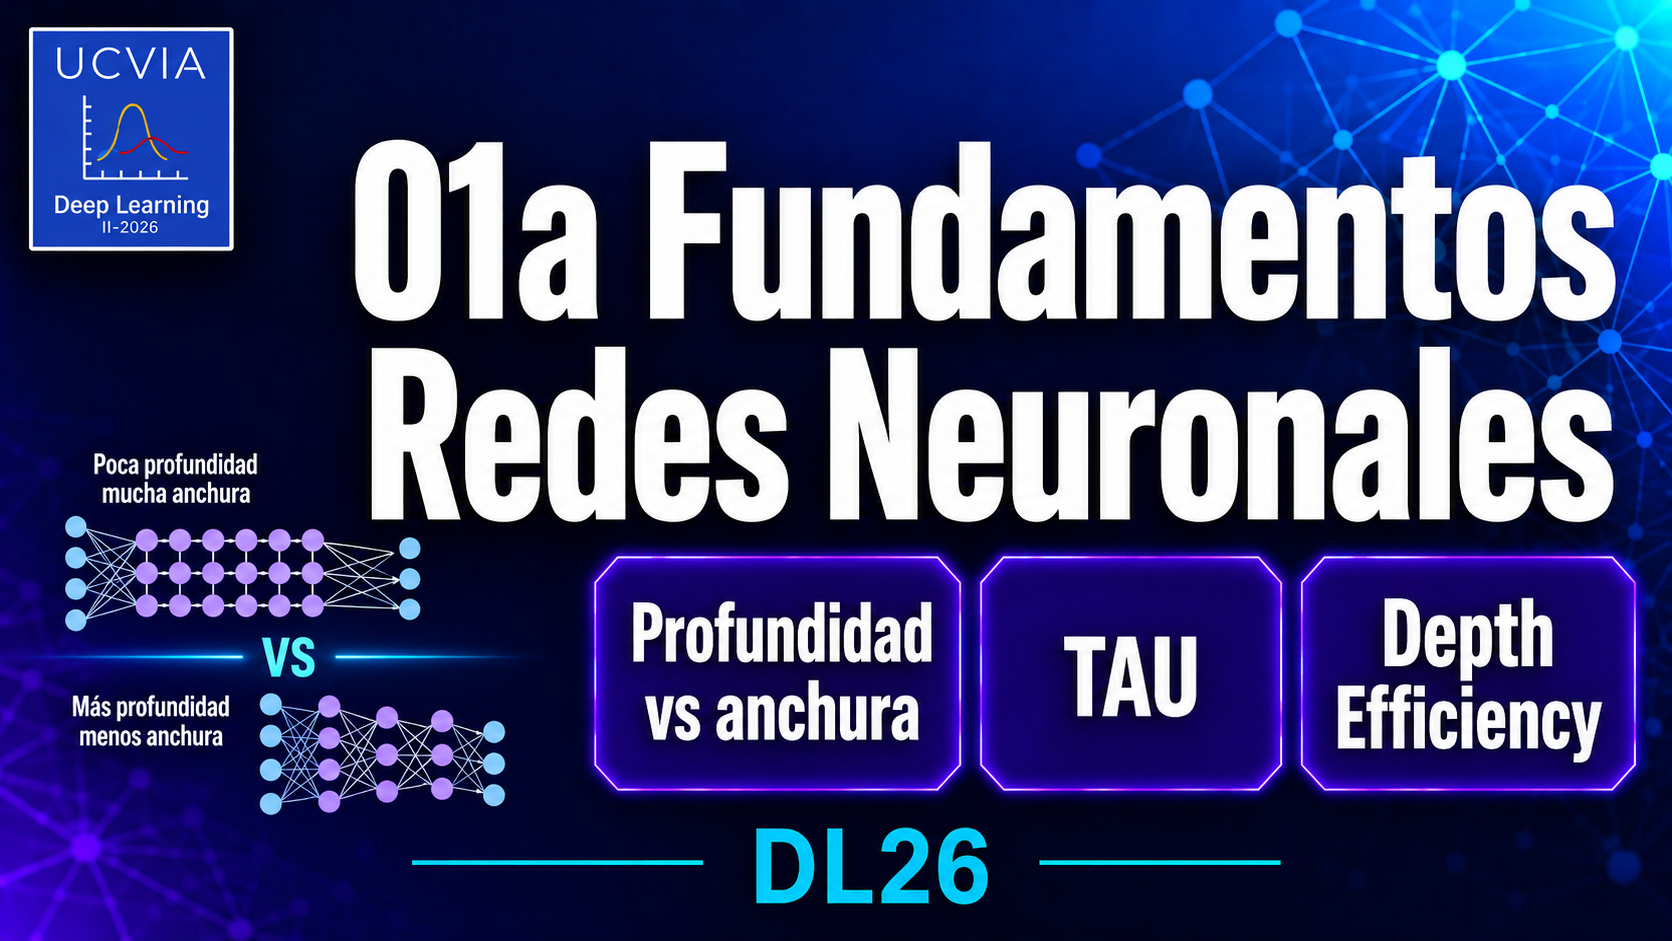 01 - Fundamentos de Redes Neuronales - profundidad vs. anchura
tl;dr: W versus L;crecimiento polinomial;versus exponencial
[Link clase] [Jupyter Notebook]
Contenido
- El número de regiones lineales de una red ReLU crece polinomialmente con la anchura $W$, pero exponencialmente con la profundidad $L$: \(\#\text{regiones} = \mathcal{O}\!\left((W/d)^{(L-1)d}\right)\)
- Sesgo, varianza e inductive bias.
-
 01 - Fundamentos de Redes Neuronales - experimentos
tl;dr: Experimentos;capacidad;implicit bias
[Link clase]
Contenido
Generamos videos con diferentes configuraciones de redes
Funciones de activación:
- RELU
- GELU
- TANH
Arquitecturas MLP con configuración
- 2-256-1
- 2-16-16-16-16-1
- 2-64-64-64-64-1
-
 02a Backpropagation - Parte 1
tl;dr: Backpropagation;Composición;Forward pass;Backward pass
[Link de la clase] [Presentación sin anotaciones] [Presentación con anotaciones]
Contenido
Introducción al algoritmo backpropagation.
Composición de funciones.
Derivadas de composición.
Ejemplo con red neuronal con funciones de activación seno, coseno y exponencial.
-
 02b Backpropagation - Parte 2
tl;dr: Backpropagation;Cálculo Matricial;Forward pass;Backward pass
[Link de la clase] [Presentación sin anotaciones] [Presentación con anotaciones]
Contenido
- Cálculo Matricial.
- $\frac{\partial \mathbf{f}_3}{\partial \mathbf{h}_3}=\frac{\partial}{\partial \mathbf{h}_3}\left(\boldsymbol{\beta}_3+\boldsymbol{\Omega}_3 \mathbf{h}_3\right)=\boldsymbol{\Omega}_3^T$
- Pase hacia adelante
- $\begin{aligned} \mathbf{f}0 & =\boldsymbol{\beta}_0+\boldsymbol{\Omega}_0 \mathbf{x}_i \ \mathbf{h}_k & =\mathbf{a}\left[\mathbf{f}{k-1}\right] \ \mathbf{f}_k & =\boldsymbol{\beta}_k+\boldsymbol{\Omega}_k \mathbf{h}_k . \end{aligned}$
- Pase hacia atrás
- $\frac{\partial \ell_i}{\partial \mathbf{f}_k}$
- $\frac{\partial \mathbf{f}_k}{\partial \mathbf{h}_k}$
- $\frac{\partial \mathbf{h}k}{\partial \mathbf{f}{k-1}}$
- $\frac{\partial \mathbf{f}_k}{\partial \boldsymbol{\beta}_k}$
- $\frac{\partial \mathbf{f}_k}{\partial \boldsymbol{\Omega}_k}$
- Cálculo Matricial.
-
 03a Algoritmos de optimización
tl;dr: SGD;Momentum;
[Link de la clase] [Presentación sin anotaciones]
Contenido
- Matemáticas
- Algoritmo de descenso gradiente
- Ejemplo de regresión lineal
- Ejemplo de modelo de Gabor
- Descenso de gradiente estocástico
- Momentum (pruebas de convergencia)
-
 03b Algoritmos de optimización
tl;dr: Nesterov;Adam
[Link de la clase] [Presentación sin anotaciones]
Contenido
- SGD con el paso Nesterov.
- Mejora de convergencia de O(1/k) a O(1/h^2)
- ADAM optimizer
- SGD con el paso Nesterov.
-
 04a Inicialización
tl;dr: Inicialización HE; Propiedades de Esperanza
[Link de la clase] [Presentación sin anotaciones] [Presentación con anotaciones]
Contenido
- Necesidad de inicialización
- Inicialización He
- Interludio: Valores esperados
- Inicialización He: intuición y pruebas
-
 04b Inicialización Xavier
tl;dr: Inicialización HE; Propiedades de Esperanza
[Link de la clase] [Presentación sin anotaciones] [Presentación con anotaciones]
Contenido
- Necesidad de inicialización
- Inicialización Xavier
- Valores esperados con Unif(-a, a)
- Inicialización Xavier: intuición y pruebas
- Ejemplos
-
 05a Redes Neuronales Convolucionales - Procesamiento de imágenes y convolución
tl;dr: Operadores punto, vecindad, convolución
[Link de la clase] [Notebook]
Contenido
- Operadores de Punto
- Brillo y contraste
- Operador Gamma
- Ejemplo de blending
- Operadores de Vecindad
- Convolución
- Kernels útiles
-
Datos
Disponibles en Materiales/CNN
- Operadores de Punto
-
 05b Redes Neuronales Convolucionales - Motivación
tl;dr: Motivación, casos 1D 2D 3D. Parámetros de kernel.
[Link de la clase] [Notebook]
Contenido
- Motivación: 3 ejemplos
- Casos de convolución para 1D, 2D, 3D.
- Hiper parámetros de generación de kerne;: Padding, stride, dimensión kernel y dilatación.
Datos
Disponibles en Materiales/CNN
-
 05c Redes Neuronales Convolucionales - Repaso desde PDI hasta Motivación de CNN
tl;dr: Motivación, casos 1D 2D 3D. Parámetros de kernel.
[Link de la clase] [Notebook]
Contenido
- Clase 1 luego de reincoporación semestre
- Repaso desde PDI hasta motivación de CNN
Datos
Disponibles en Materiales/CNN
-
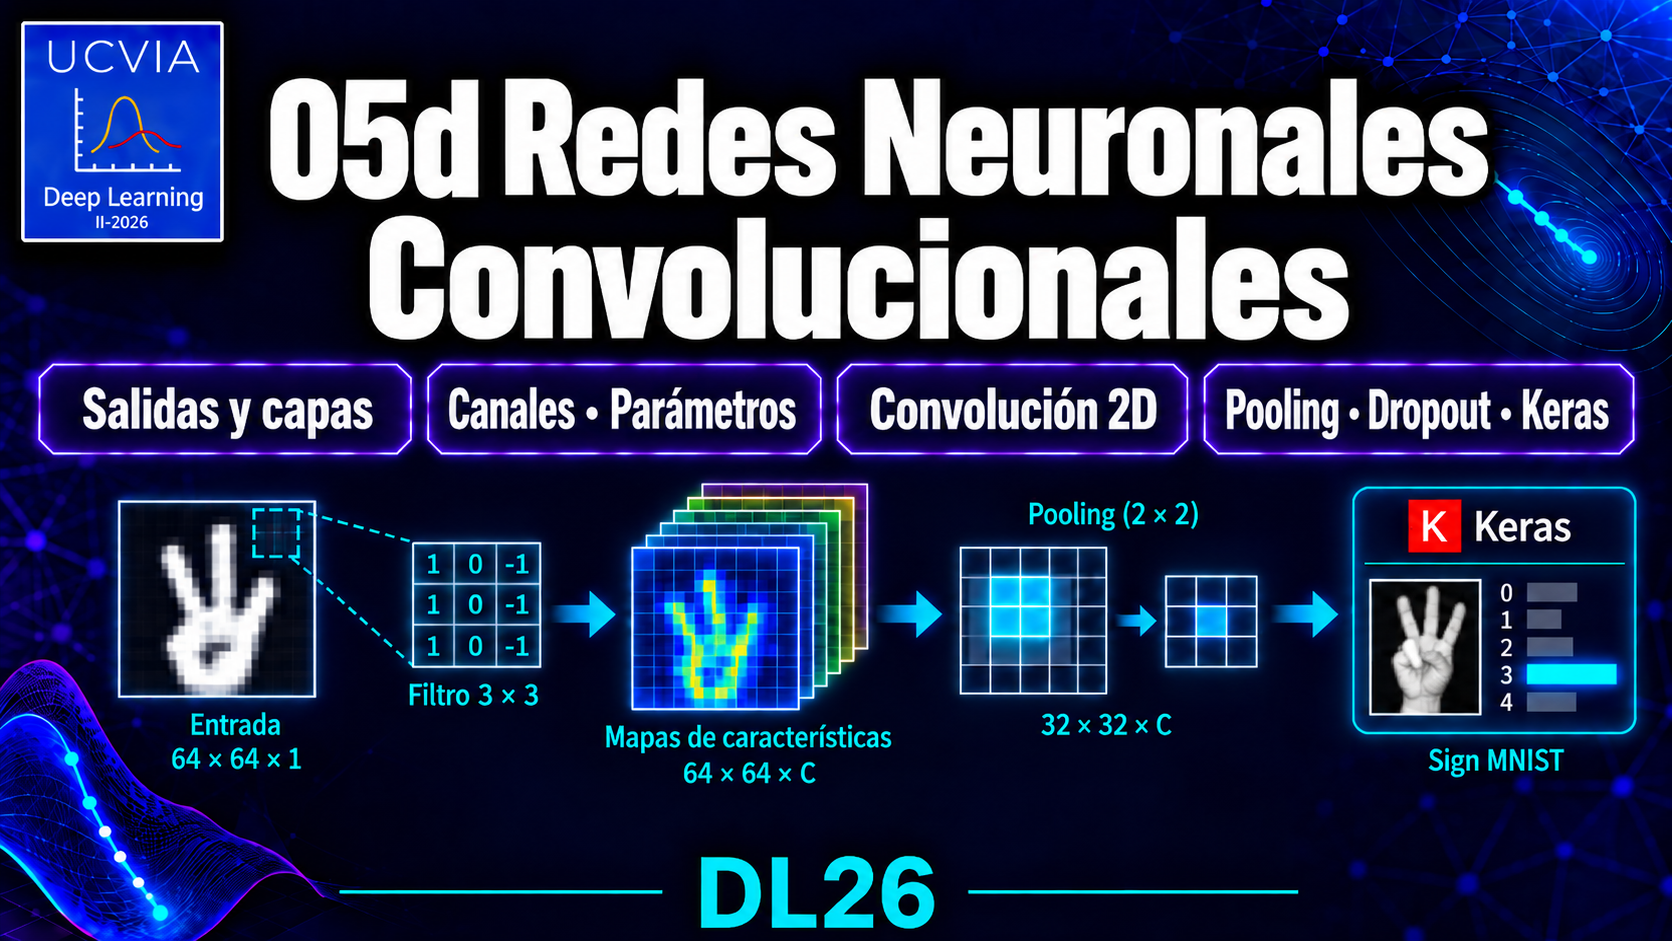 05d Redes Neuronales Convolucionales - Capas especiales de CNN y Ejemplo Keras
tl;dr: Capas, Pooling, Dropout, Keras
[Link de la clase] [Notebook]
Contenido
- Tamaño de salidas de capas
- Cómo cambian las capas?
- Canales
- Cantidad de parámetros?
- Convolución en 2D
- Pooling
- Dropout
- Ejemplo en Keras
Faltó: Normalización, Campos receptivos y Aplicaciones
Datos
Disponibles en Materiales/CNN
-
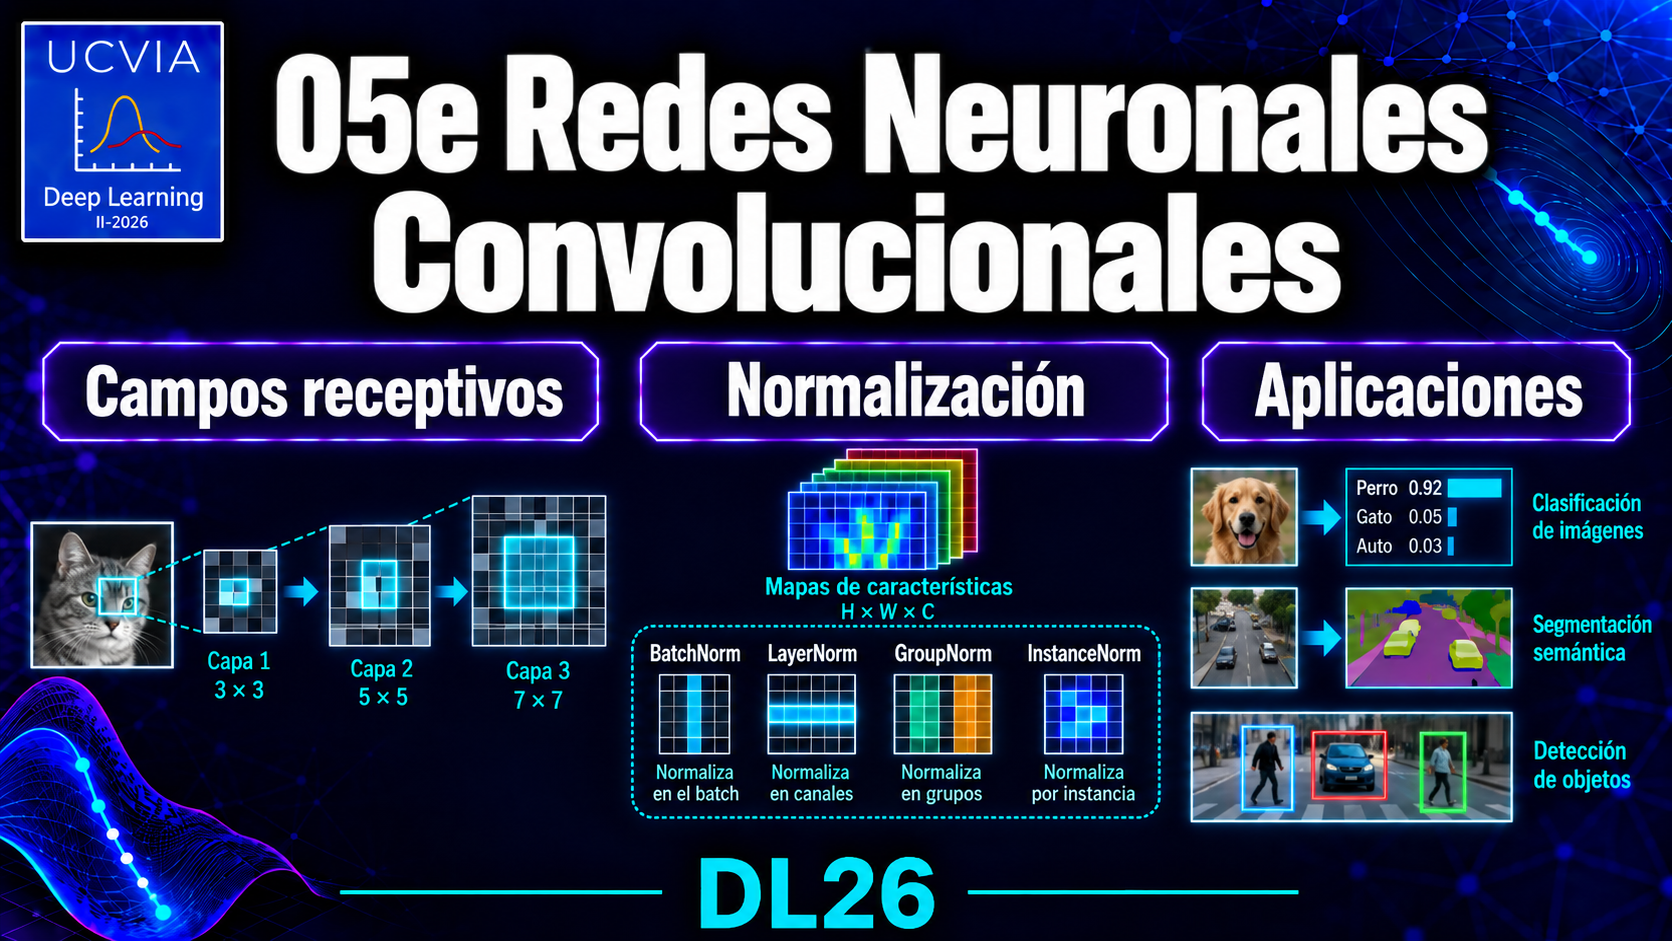 05e Redes Neuronales Convolucionales - Campos receptivos, Normalización y Aplicaciones
tl;dr: BatchNormalization, LayerNormalization, GroupNormalization, InstanceNormalization, AlexNet, ImageNet.
[Link de la clase] [Notebook]
Contenido
- Normalización: BatchNormalization, LayerNormalization, GroupNormalization, InstanceNormalization
- Campos receptivos
- Aplicaciones
Datos
Disponibles en Materiales/CNN
-
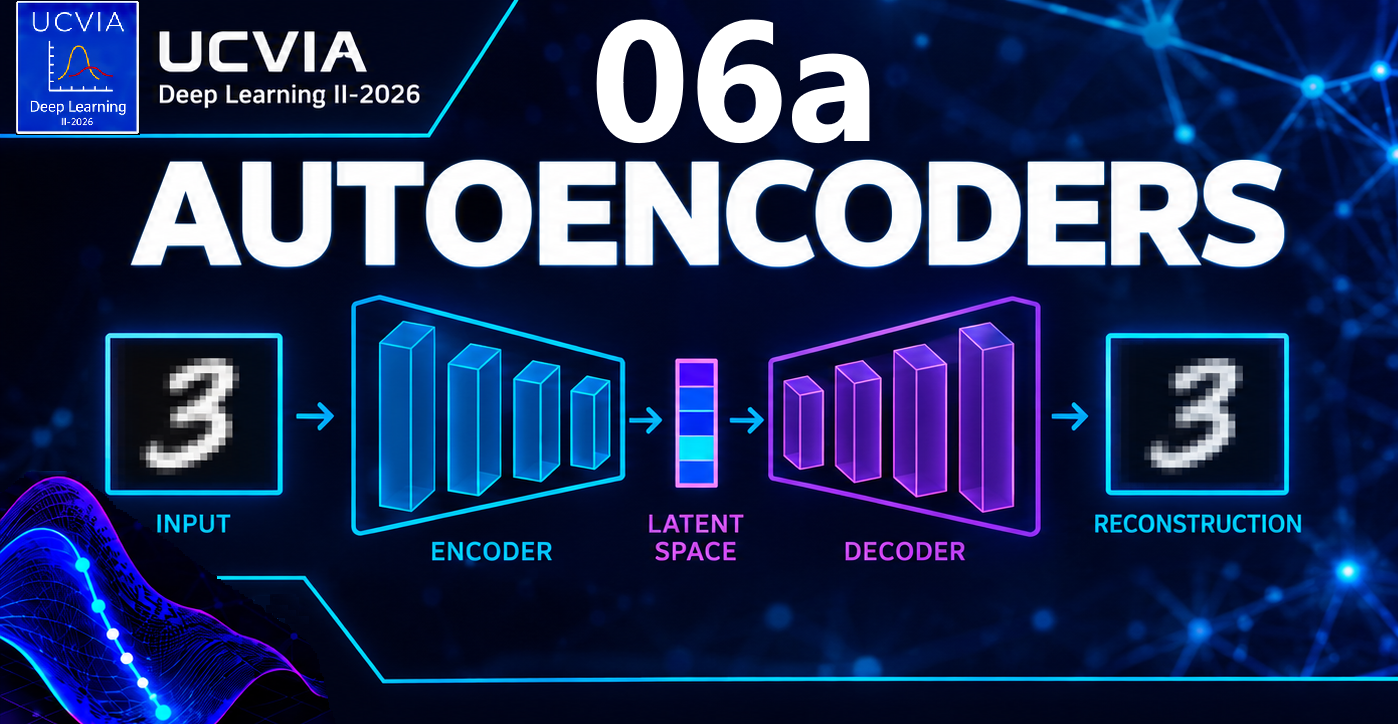 06a Autoencoders - Compresión, Reconstrucción y Denoising
tl;dr: Autoencoders, espacio latente, compresión, reconstrucción, denoising.
[Link de la clase] [Notebook]
Contenido
- Autoencoders
- Compresión
- Reconstrucción
- Denoising
Datos
Se usa MNIST, que se descarga automáticamente desde el notebook.
-
 06b Autoencoders - ¿Qué aprende el cuello de botella?
tl;dr: Espacio latente de 2 dimensiones, visualización de la representación aprendida.
[Link de la clase] [Notebook]
Contenido
- ¿Qué aprende el cuello de botella?
Datos
Se usa MNIST, que se descarga automáticamente desde el notebook.
-
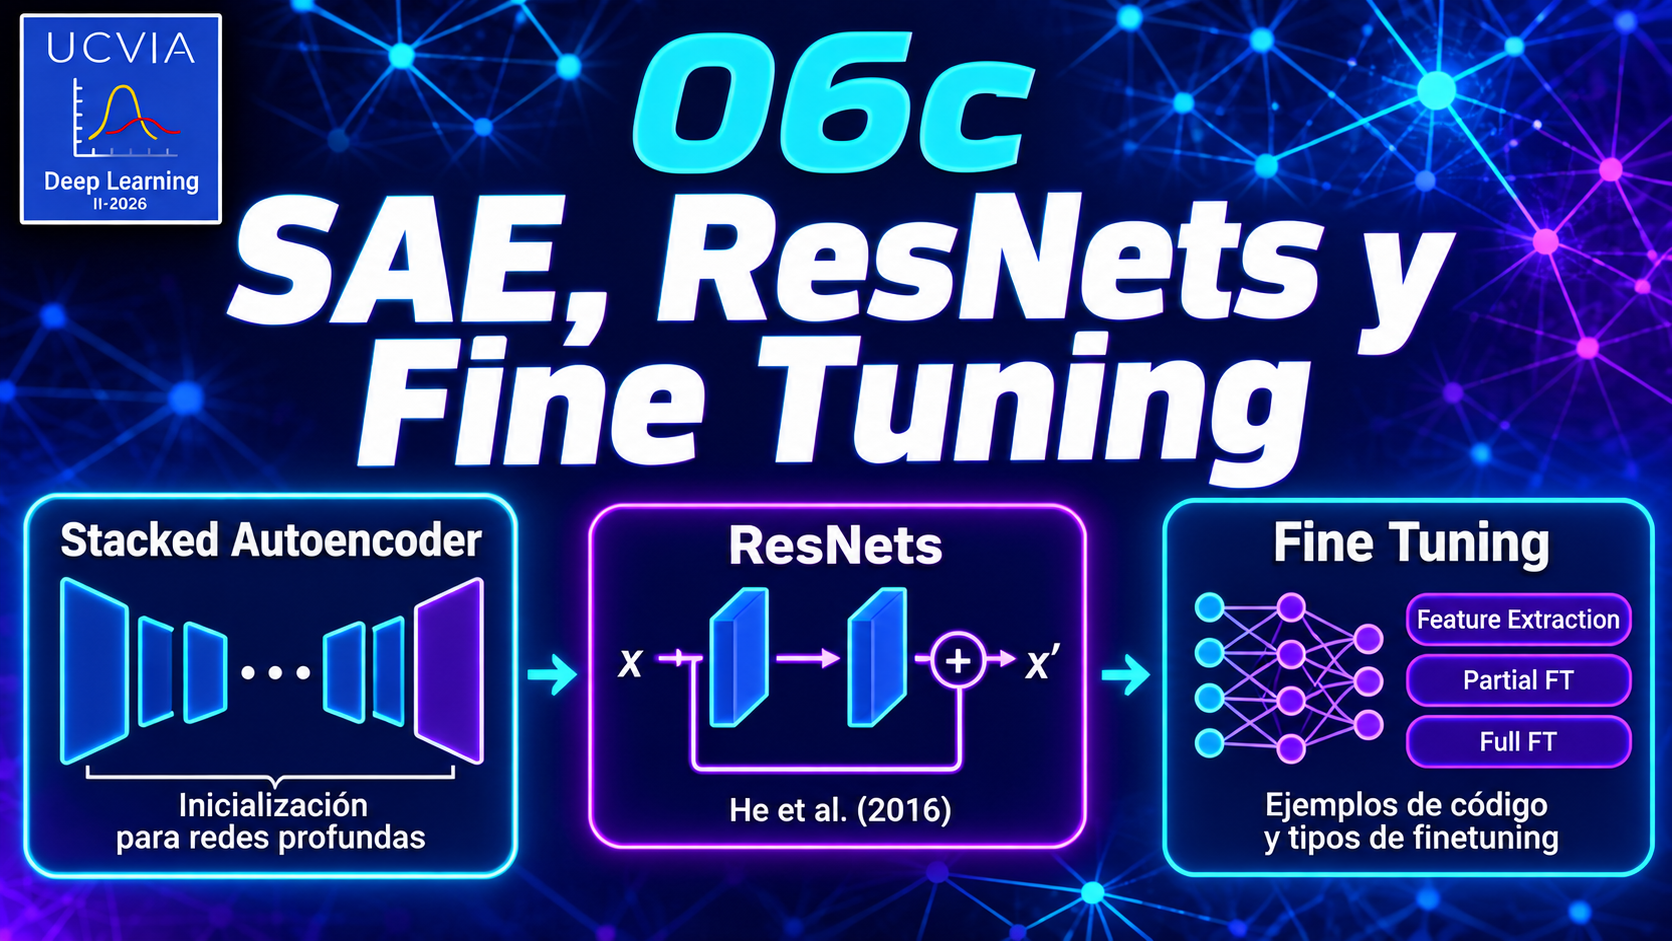 SAE, ResNets y Fine Tuning
tl;dr: AutoEncoders vs ResNet;Inicialización vs Arquitectura;Finetuning
[Link de la clase] [Notebook]
Contenido
- El stacked autoencoder resolvía el problema de entrenar redes profundas por la inicialización
- ResNets: He et al. (2016) lo resolvieron por la arquitectura
- Ejemplo de código de FineTuning y tipos de finetuning
Datos
Se usa MNIST, que se descarga automáticamente desde el notebook.